
サービスの詳細を表示
サービス詳細オプション(/en-us/netscaler-console-service/media/sg-details.png)
サービス詳細ページでは、以下を表示できます。
-
サービスがホストされているクラスター名 (1)
-
サービスのネームスペースとサービスラベル (2) (4)
-
選択したサービスに接続されている、関連するすべての受信および送信サービス (3)
-
詳細については、「ゴールデンシグナルメトリックを使用したサービスの監視」を参照してください。
-
サービスに関連付けられているバックエンドポッド (6)。サービスの詳細(/en-us/netscaler-console-service/media/sg-details-more.png)
これらの主要メトリックの傾向を使用して、特定の期間におけるサービスのパフォーマンスを分析できます。
たとえば、サービスがすべてのリクエストに対してサービス応答時間 > 700 ミリ秒を示しているとします。管理者として、次のことができます。
-
特定の期間のサービス応答時間メトリックの傾向を分析する
-
問題をトラブルシューティングする
-
サービス応答時間メトリックを再度確認し、応答時間が改善されたかどうかを分析します
Related information
メトリックの詳細
| メトリック | 説明 |
|---|---|
| ヒット数 | サービスが受信したリクエストの総数 |
| エラー | サービスからのHTTPエラーの総数 |
| サービス応答時間 | サービスがTime To First Byte (TTFB) に応答するまでにかかった平均応答時間。 |
| データ量 | サービスによって処理されたデータ総量 |
| SSLフロントエンドエラー | サービスからのSSLフロントエンドエラーの総数。例: SSL CLIENTAUTH FAILURE |
| SSLバックエンドエラー | サービスからのSSLバックエンドエラーの合計。例:SSLクライアントエラー |
| TCPバックエンドエラー | サービスからのTCPバックエンドエラーの合計。例:TCPサーバーリセット |
| TCPフロントエンドエラー | サービスからのTCPフロントエンドエラーの合計。例:TCPクライアントリセット |
バックエンドPodの詳細を表示
サービスに関連付けられているバックエンドPodを表示するには、Podsタブをクリックします。
バックエンドPod(/en-us/netscaler-console-service/media/backend-pod-details.png)
-
Pod名 – Pod名を示します
-
ステータス – Podが実行中(UP)か、そうでないか(DOWN)を示します。
-
IPアドレス – PodのIPアドレスを示します
Poll Nowオプションを使用してPodのステータスを取得する
Poll Nowオプションは、クラスターから最新のPodステータスを取得します。
今すぐポーリング(/en-us/netscaler-console-service/media/sg-poll-now.png)
ゴールデンシグナルメトリクスを使用してサービスを監視する
Kubernetesクラスターで実行されているサービスにおけるゴールデンシグナルメトリックとは、特定の期間における潜在的な異常を検出できる一連のメトリックを指します。Kubernetesクラスターに100個ものマイクロサービスがある場合、頻繁に問題が発生するサービスを特定するのは難しいかもしれません。NetScaler ConsoleグラフがKubernetesサービスの潜在的な異常を特定するのに役立つ、以下の3つの主要なメトリックがゴールデンシグナルメトリックです。
-
ヒット数
-
応答時間 (平均) および応答時間 (P99)
-
エラー
管理者として、これらのメトリックを使用すると、次のことができます。
-
サービスステータスの特定
-
重大 – サービスに複数のメトリックで異常またはしきい値違反がある
-
レビュー – サービスにいずれかのメトリックで異常またはしきい値違反がある
-
良好 – サービスに異常またはしきい値違反がない
-
-
各メトリックで特定された異常の数を分析する
-
問題をトラブルシューティングし、大きな影響を回避する
異常の特定
サービスをクリックして詳細の表示を選択すると、サービス詳細ページにすべてのメトリックの概要が表示されます。異常のあるメトリックタブをクリックして、異常の詳細を表示します。
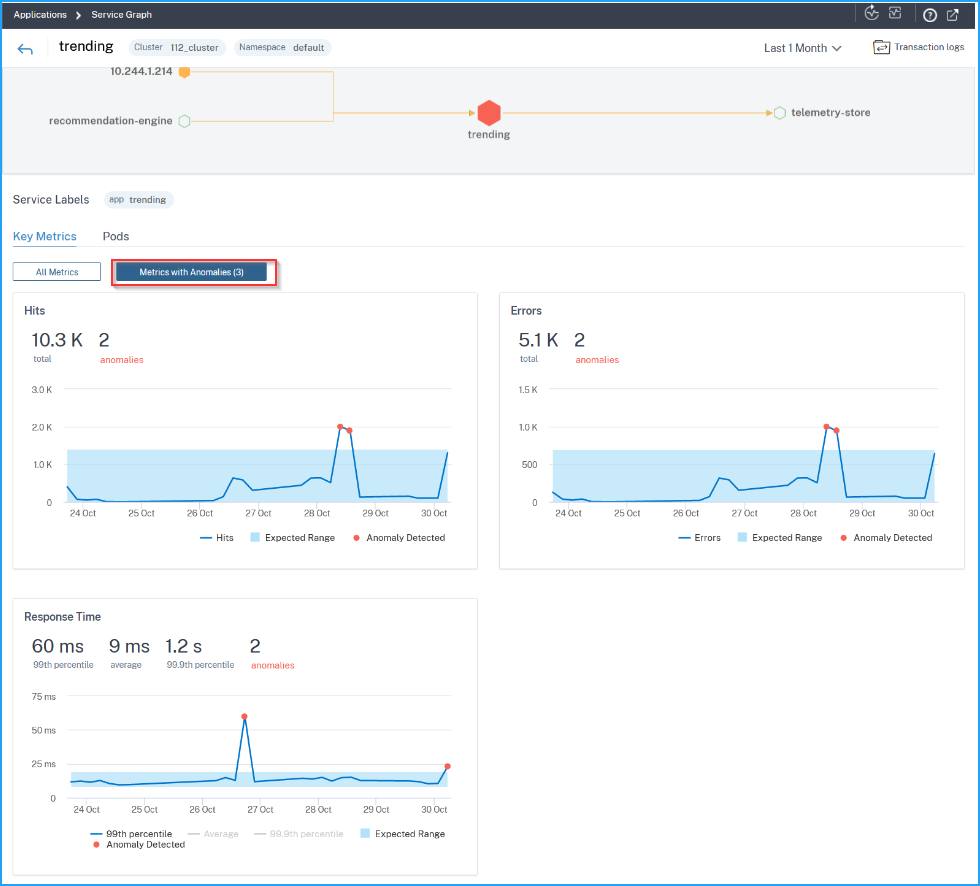
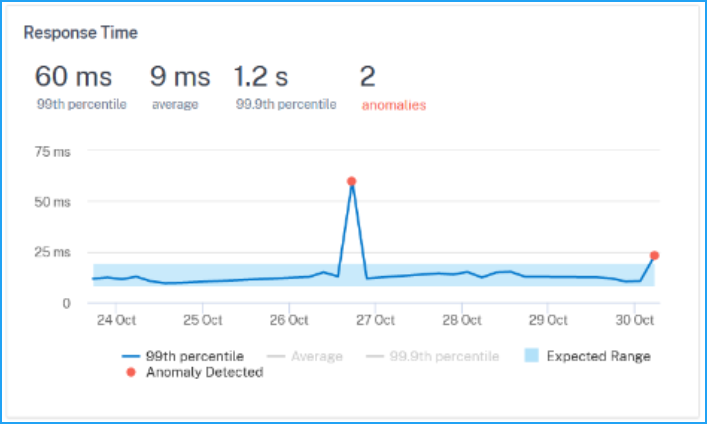
各メトリックについて、グラフでは、予想範囲を超えたときに検出された異常を表示できます。オプションをクリックして、グラフのビューをフィルタリングできます。
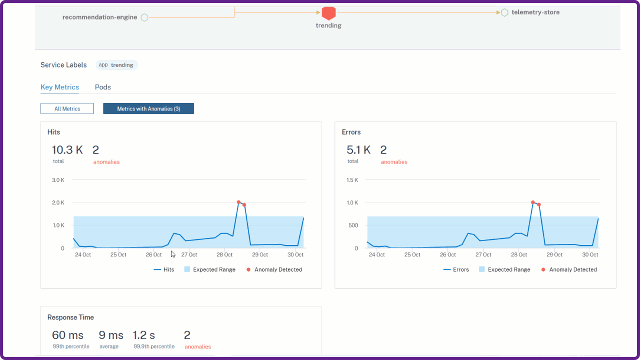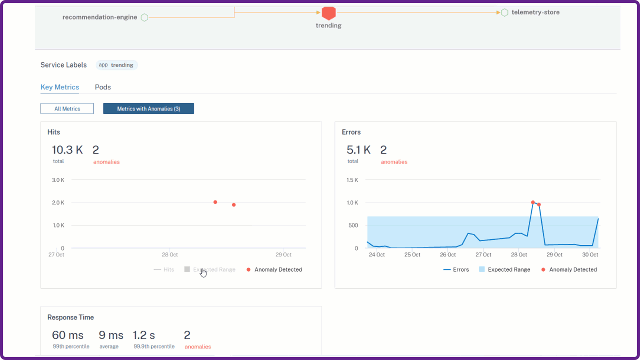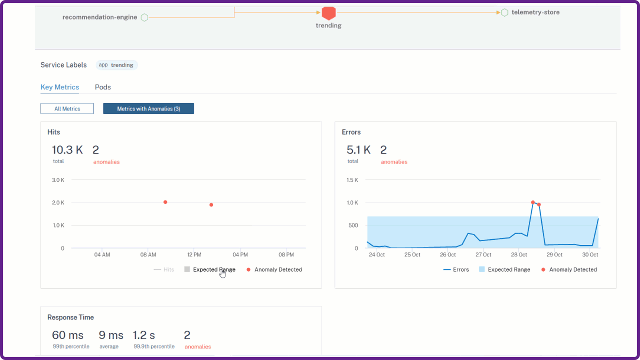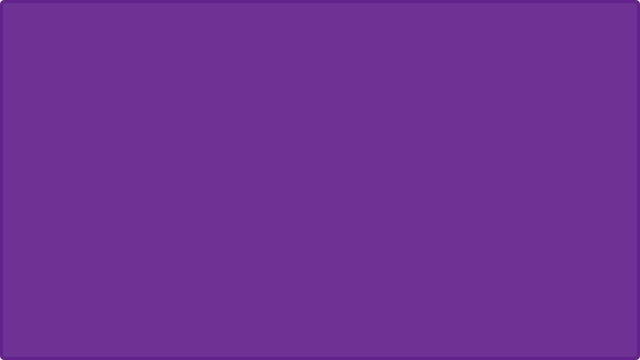
サービス応答時間 (P99) の異常を分析したいとします。
応答時間の下に、選択した期間の次の詳細を表示できます。
-
99パーセンタイル – 選択した期間のリクエストの99%が60ミリ秒未満であることを示します。
-
平均 – サービスからの平均応答時間を示します。
-
99.9パーセンタイル – サービスからの最高応答時間を示します。
-
異常 – 検出された異常の合計数を示します。
このグラフでは、選択した期間の予想範囲も表示できます。例によると、以下を表示できます。
-
応答時間の予想範囲は1ミリ秒から9ミリ秒です。
-
サービスで2つの異常が検出されました(1つは60ミリ秒、もう1つは25ミリ秒)。これは、サービスの応答時間が予想範囲(1ミリ秒から9ミリ秒)を超えているためです。